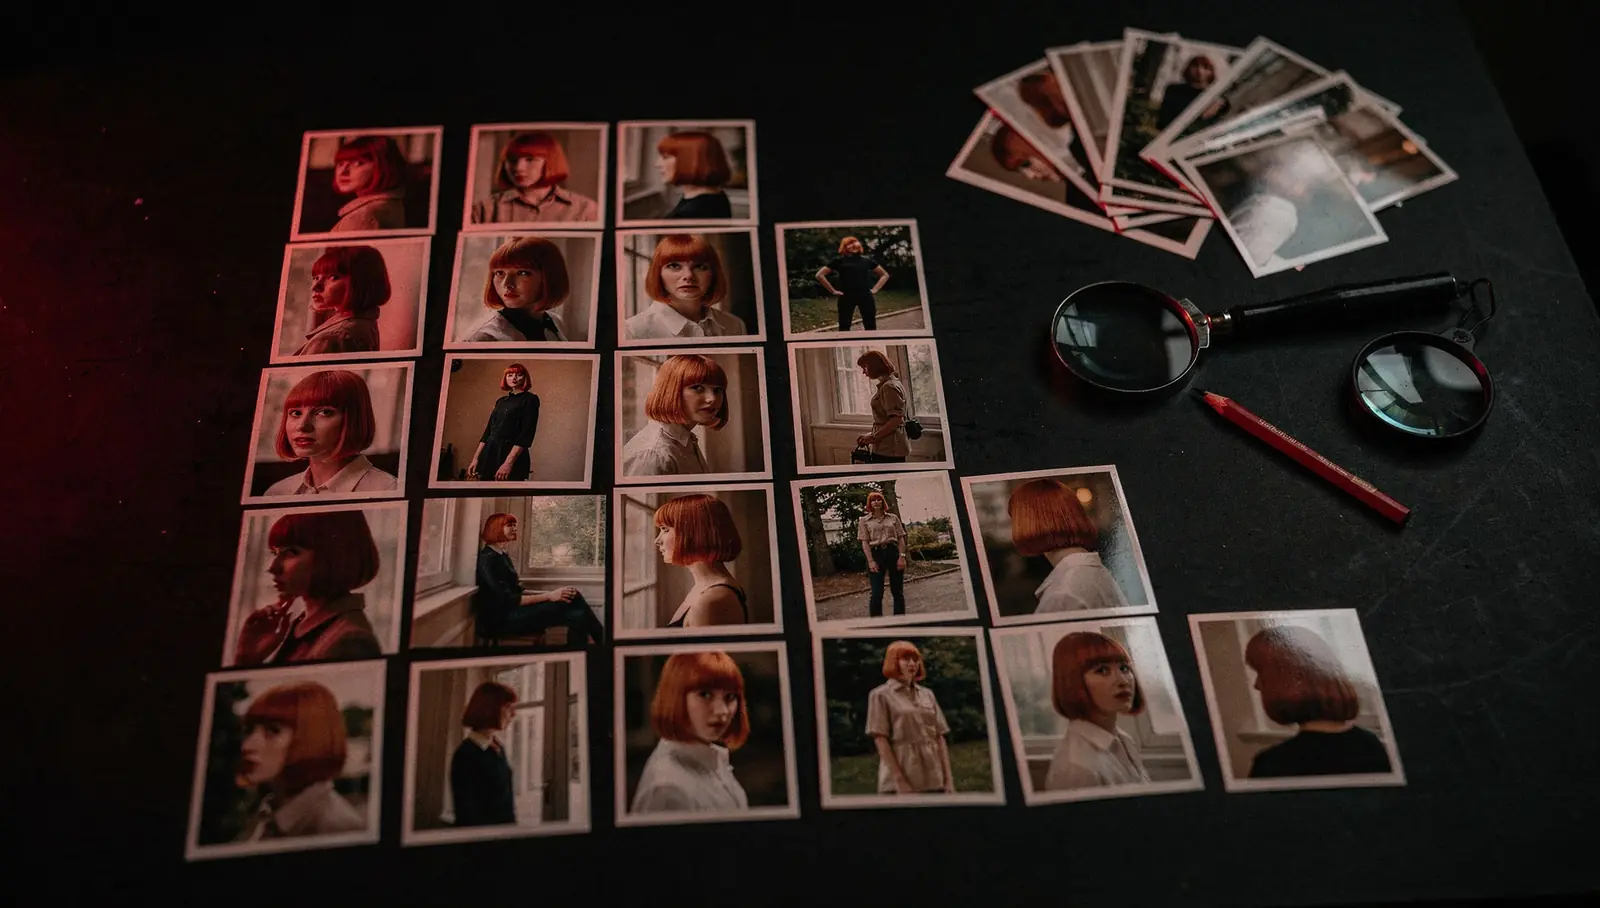
Сколько фото нужно для лоры — первый вопрос, который задают все, и не самый важный. LoRA персонажа на 15 резких и разных снимках обычно получается лучше, чем на 80 почти одинаковых селфи. Решает не число файлов, а то, что в них: ракурсы, свет, фон, одежда и чистота каждого кадра.
Ниже — практическая сторона подготовки датасета для LoRA на SDXL и Flux: сколько фото нужно, какие кадры снять, что выкинуть, как писать подписи и выбирать триггер-слово и как проверить готовую LoRA до того, как строить на ней кампанию. Если вы разбираетесь, как обучить лору персонажа, начинать стоит именно с датасета. Опираемся на открытую документацию (kohya-ss sd-scripts, ai-toolkit, Hugging Face, Replicate, тренер Civitai) и на свой пайплайн: мы обучаем LoRA персонажей на SDXL через kohya по 5–25 фото на персонажа.
Короткий ответ: сколько фото нужно для лоры
Точная цифра в источниках расходится — все тестируют разные объекты и настройки, — но диапазоны пересекаются:
- В экспериментах Hugging Face с LoRA на SDXL рабочую LoRA лица получили на 6 тщательно отобранных фото, и вывод там прямой: меньше, но лучше отобранных кадров работает лучше, чем больше посредственных.
- Документация Replicate по обучению Flux советует 10–20 фото и называет 10 хорошим минимумом. Собственный тренер Black Forest Labs предлагает 5–20.
- Гайды на Civitai для персонажа обычно ориентируются примерно на 20–30 фото, для стилей и персонажей с несколькими образами — больше.
Рабочий ориентир для датасета под SDXL и Flux:
| Что обучаем | Обычный диапазон | Комментарий |
|---|---|---|
| Реальный человек, один образ | 10–20 | 6–10 хватит, если каждый кадр сильный |
| Персонаж в нескольких образах | 20–30 | по несколько кадров на каждый образ |
| Рисованный маскот | 15–25 | все кадры строго по модели персонажа |
| Товар | 10–25 | все стороны плюс крупные планы деталей |
| Стиль (для сравнения) | 20–50+ | разные сюжеты в одном стиле |
Почему качество важнее количества. LoRA запоминает то, что повторяется в датасете. Если 20 из 30 фото сняты за один вечер в одной толстовке, модель выучит «этого человека в этой толстовке в этой комнате». Каждый слабый кадр — размытый, с фильтром, с чужим лицом — учится с тем же весом, что и лучший. Новое фото помогает, только если добавляет то, чего нет в остальных: новый ракурс, свет, одежду или обстановку. После 25–30 фото одного образа обычно добавляются повторы, а не информация.
По количеству фото SDXL и Flux почти не отличаются. Основная разница — в подписях, о них ниже.
Чек-лист съёмки: ракурсы, свет, фон, одежда
Для реального человека датасет должен закрыть все вопросы, которые модель может «задать» про лицо и фигуру:
- Крупность. Разумная стартовая пропорция: примерно половина — крупные планы и портреты по плечи, около трети — по пояс, остальное — в полный рост. В экспериментах Hugging Face крупные планы дают реалистичность, а несколько хороших кадров в полный рост помогают LoRA справляться с новыми позами.
- Ракурсы. Анфас, три четверти с обеих сторон, профиль, немного сверху и снизу.
- Мимика. Нейтральное лицо, улыбка, разговор, серьёзное выражение — всё, что понадобится в контенте. LoRA, обученная только на улыбках, плохо выглядит серьёзной.
- Свет. Дневной на улице, тёплый в помещении, вспышка или студия, пасмурно, контровой. Фото с разных дней и съёмок лучше одной длинной фотосессии.
- Фон. Меняйте каждые несколько кадров. Повторяющаяся стена или диван запоминаются как часть персонажа.
- Одежда. Разная — если только наряд не часть персонажа (униформа, фирменная куртка). Тогда оставьте его и учтите в подписях.
- Причёска и возраст. Одинаковые. Документация тренера Flux на Replicate не советует смешивать разные стрижки и возраст в одном датасете, а также делать много кадров с руками у лица — по их наблюдению, это добавляет артефактов на руках.
Разрешение и кадрирование
- SDXL обучается примерно на 1024 px. Идеально, если исходники не меньше этого по короткой стороне. Документация kohya-ss предупреждает о картинках сильно меньше разрешения обучения, а апскейл превью на 400 px настоящих деталей не добавит.
- Квадратная обрезка не обязательна: kohya с бакетингом по пропорциям и ai-toolkit сами раскладывают кадры разных пропорций (ai-toolkit уменьшает картинки, но никогда не увеличивает).
- Персонаж должен занимать заметную часть кадра. Hugging Face советует избегать фото, где человек снят издалека.
- Берите оригиналы, а не пережатые мессенджером копии, и без бьюти-фильтров.
Что убрать из датасета для LoRA
Убрать плохие кадры часто полезнее, чем добавить хорошие. Выбрасывайте или исправляйте:
- Дубли и почти дубли. Серийная съёмка и одна поза с разницей в секунду дают одному моменту многократный вес.
- Размытые, шумные и маленькие кадры, включая смаз от движения и сильное сжатие.
- Чужие лица. Hugging Face рекомендует, чтобы других лиц в датасете не было вовсе. Обрежьте, если персонаж останется крупным, иначе уберите фото.
- Водяные знаки, логотипы, дата и время, подписи, элементы интерфейса. Модель их выучит, и они вернутся артефактами.
- Текст на одежде и фоне, если он не часть персонажа.
- Сильные фильтры, ретушь «под глянец», маски и эффекты, непривычный для человека макияж.
- Очки, маски и шапки, закрывающие лицо, больше чем на одном-двух кадрах.
- Коллажи, скриншоты, зеркальные селфи, где телефон закрывает пол-лица.
Подписи и триггер-слово
Триггер-слово — короткий редкий токен, к которому LoRA привязывает персонажа. Гайд Replicate советует строку, которая не является словом ни в одном языке, и не брать TOK: его уже используют множество чужих моделей. Hugging Face отмечает, что даже у редких токенов бывает своё значение, так что проверяйте. К триггеру добавляйте слово класса: mrv4 woman, k0ri fox mascot, brn7 bottle.
Подписи — текстовые файлы рядом с картинками, с тем же именем: 01.jpg и 01.txt. Так их читают и kohya-ss, и ai-toolkit. Главное правило: то, что написано в подписи, остаётся управляемым через промпт; то, что есть на каждом кадре и нигде не подписано, впитывается в триггер-слово. Документация kohya-ss описывает ровно это: если учить только на «идентификатор + класс», одежда и фон могут прилипнуть к идентификатору, и поменять их промптом будет трудно; подробные подписи их разделяют.
dataset/
  01.jpg  01.txt  mrv4 woman, close-up, smiling, grey knit sweater, window light, blurred kitchen
  02.jpg  02.txt  mrv4 woman, full body, walking, black coat, city street at night, neon light
  03.jpg  03.txt  mrv4 woman, profile, neutral expression, white t-shirt, plain grey studio backdrop
Подписи обычно пишут по-английски — на этом языке обучены текстовые энкодеры SDXL и Flux. Практические правила:
- Описывайте то, что меняется от кадра к кадру: одежду, позу, крупность, обстановку, свет, мимику.
- Не описывайте то, что всегда должно приходить вместе с персонажем: лицо, телосложение, фирменные цвета маскота.
- Не давайте всем фото одну и ту же подпись. Hugging Face предупреждает, что одинаковые подписи могут ухудшить результат.
- Автоподписи — черновик. Модели-подписчики путают возраст и пол, придумывают предметы и пропускают одежду. Перечитайте каждую строку.
Обучение LoRA на Flux и SDXL: чем отличаются подписи
Тренер Civitai в документации называет подписи-теги (теги через запятую от WD tagger) предпочтительными для SDXL, а подписи обычными предложениями — для Flux. Для фотореалистичного SDXL хорошо работают короткие описательные фразы, как в примере выше. Многие тренеры считают подписи необязательными, но, по наблюдению Civitai, с ними модель обычно получается гибче.
Персонаж, маскот, товар: в чём разница
Реальный человек
Цель — сходство. Его в основном несут крупные планы, поэтому резких, хорошо освещённых портретов не жалейте. Причёска и возраст — одни и те же, съёмок — несколько, а проверять надо на промптах, которые меняют одежду и место: если LoRA выдаёт человека только в его обычной куртке, она выучила куртку.
Маскот или рисованный персонаж
Цель — постоянство дизайна: пропорции, цвета, мелкие детали, по которым маскота узнают. Каждое изображение должно быть строго по модели. Рисунки «не по модели» не игнорируются, а усредняются. Часто у маскота есть только один-три официальных рисунка, и этого мало. Тогда датасет сначала собирают: иллюстратор рисует разворот (анфас, три четверти, профиль, спина), позы и эмоции, или недостающие ракурсы генерируют по референсу и оставляют только совпадающие с моделью. Манера рисунка тоже запоминается: если все кадры в плоском векторе, маскот и будет выходить плоским вектором. Нужен в нескольких стилях — включите их и назовите стиль в подписях.
Товар
Цель — форма, материалы, цвет и этикетка. Снимайте все стороны, три четверти и сверху, добавьте крупные планы деталей (фактура, швы, застёжки, крышки) и чередуйте нейтральный фон с кадрами в интерьере. Если у товара несколько цветов, подписывайте цвет или обучайте отдельную LoRA на вариант. Ограничения честно: мелкий текст и маленькие логотипы редко выходят буква в букву, прозрачные и зеркальные поверхности сложнее матовых. Если товаров сотни, LoRA на каждый выходит дорого — для каталогов есть отдельная задача, см. фото для карточек товаров.
Как проверить обученную LoRA
Оценивать LoRA по кадрам из датасета бессмысленно. Смотрите, что она делает на промптах, которых не видела. Соберите небольшую тестовую сетку с фиксированными сидами:
- Простой студийный портрет на нейтральном фоне — базовая проверка сходства.
- В полный рост в обстановке, которой нет в датасете, например на улице в закатном свете.
- В одежде, в которой персонажа на обучающих фото не было.
- В другой технике: иллюстрация или 3D для фото-LoRA, фото для маскота.
- Слово класса без триггера, например «photo of a woman». Ваш персонаж выйти не должен. Если выходит — LoRA протекает на весь класс; в документации kohya-ss это называется language drift, против него используют регуляризационные изображения.
- Те же промпты на нескольких силах LoRA (например, 0.6, 0.8 и 1.0) и на том чекпойнте, с которым будете работать: LoRA, обученная на базовой модели, на дообученном чекпойнте может выглядеть иначе.
Признаки переобучения:
- Что ни пиши, возвращаются обучающие кадры: та же поза, фон, куртка.
- Промпт игнорируется: одежда и место не меняются.
- Пережжённые цвета, лишний контраст, шум, потеря деталей. В разборе DreamBooth от Hugging Face шумная, деградировавшая картинка названа типичным симптомом.
- Нормально выглядит только на малой силе.
Признаки недообучения: сходство то появляется, то пропадает, персонаж похож скорее на родственника, чем на человека, триггер почти ничего не меняет, детали маскота или товара «плывут».
Что делать при переобучении: взять более ранний чекпойнт (в документации Diffusers прямо сказано, что промежуточный может оказаться лучше финального), учить меньше шагов или с меньшим learning rate, снизить силу LoRA, разнообразить данные. При недообучении: больше шагов, больше резких крупных планов и проверка подписей — не описано ли в них лицо так подробно, что триггеру нечего запоминать.
В нашем пайплайне после обучения каждая LoRA проходит проверочную сетку тестовых сцен (студия, улица, крупный портрет, интерьер) — до любой массовой генерации.
Права на образ
- Реальный человек — только с его согласия. LoRA на знаменитостях, публичных людях и по запросам «сделайте похожим на…» не обучаем.
- Никакого adult-контента — ни с LoRA, ни без.
- У фото тоже есть владелец. Убедитесь, что у вас есть право их использовать, особенно если это профессиональная съёмка.
- Маскот или фирменный персонаж должен принадлежать вам или быть у вас по лицензии.
- У базовой модели и чекпойнта есть лицензии, от которых зависит коммерческое использование, — см. наш гайд о лицензиях моделей с Civitai.
Когда проще отдать нам
Для экспериментов LoRA имеет смысл обучить самому. Если персонаж нужен в сотнях картинок или роликов, основное время уходит на датасет, подписи, проверку и прогоны генерации.
Как это устроено у нас: вы присылаете 5–25 фото и описываете, где будет использоваться персонаж. Мы готовим подпись к каждому фото (их можно поправить до начала обучения), обучаем LoRA на SDXL через kohya и показываем проверочную сетку. После одобрения LoRA идёт в ваш воркфлоу генерации: сначала пробная партия, потом объём, результат отсматриваем вручную.
Обучение LoRA персонажа, маскота или товара — от $99 разово. Подробности — на странице услуги, заявка — через форму.